Statistiek gebruiken
Variabelen en diagrammen, samenhang en causaliteit, groepen vergelijken met het formuleblad (phi, max Vcp, effectgrootte, boxplots), normale verdeling en betrouwbaarheidsintervallen.
Klik een paragraaf open, en daarna de opdracht die je wilt nakijken.
14 opdrachten
Zo pak je het aan
Een variabele indelen. Gebruik het schema uit het boek en schrijf je antwoord altijd met "want":
- Zijn de waarden getallen die een hoeveelheid voorstellen? - Nee: de variabele is kwalitatief. Ga naar stap 2. - Ja: de variabele is kwantitatief. Ga naar stap 3.
- Is er een logische volgorde? Nee: nominaal. Ja: ordinaal.
- Zijn alle tussenliggende waarden mogelijk? Nee: discreet. Ja: continu.
Een voorbeeld van een goed antwoord: "Ordinaal, want de waarden zijn geen hoeveelheden en hebben een logische volgorde."
Een diagram kiezen. Kijk naar wat je wilt laten zien.
- Een verdeling van één variabele: dotplot, histogram, boxplot of steel-bladdiagram.
- Een samenhang tussen twee variabelen: spreidingsdiagram (puntenwolk).
- Een verloop in de tijd: lijndiagram.
Bij kwalitatieve data kun je alleen een staafdiagram, een cirkeldiagram of een (cumulatieve) frequentietabel maken. Daarbij kun je van de centrummaten alleen de modus gebruiken (bij een ordinale variabele ook de mediaan). Bij kwantitatieve data kan elk diagram.
Data indelen in klassen of categorieën is eenrichtingsverkeer. Je verliest informatie: uit de klassen kun je de oorspronkelijke waarden niet meer terughalen.
Opdracht V1
- Geboortejaar: discreet, want de waarden zijn hoeveelheden en niet alle tussenliggende waarden zijn mogelijk.
- Hoogst genoten opleiding: ordinaal, want de waarden zijn geen hoeveelheden en hebben een logische volgorde.
- Telefoonnummer: nominaal, want de waarden zijn geen hoeveelheden (een telefoonnummer is een code, geen aantal) en hebben geen logische volgorde.
- Mogen we u mail sturen?: nominaal, want de waarden (ja/nee) zijn geen hoeveelheden en hebben geen logische volgorde.
Opdracht V2
a Ordinaal, want de kleuren zijn geen hoeveelheden, maar hebben wel een logische volgorde: elke kleur hoort bij een zone, en de zones liggen op volgorde van buiten naar het midden.
b Discreet, want de waarden zijn hoeveelheden en niet alle tussenliggende waarden zijn mogelijk (alleen hele puntaantallen).
c Continu, want de waarden zijn hoeveelheden en alle tussenliggende waarden zijn mogelijk.
d Nominaal, want de namen zijn geen hoeveelheden en hebben geen logische volgorde.
Opdracht V3
- Aantal gele kaarten: kwantitatief, want de waarden zijn hoeveelheden. Discreet, want niet alle tussenliggende waarden zijn mogelijk.
- Zorgen over nalatenschap: kwalitatief, want de waarden zijn geen hoeveelheden. Ordinaal, want de waarden hebben een logische volgorde.
- BMI: kwantitatief, want de waarden zijn hoeveelheden. Continu, want alle tussenliggende waarden zijn mogelijk.
- Bloedgroep: kwalitatief, want de waarden zijn geen hoeveelheden. Nominaal, want de waarden hebben geen logische volgorde.
Opdracht 1
a Nee. Bij een lijndiagram staat op de horizontale as een kwantitatieve variabele, zoals de tijd. Geslacht is kwalitatief (nominaal), dus dat kan niet.
b Ja. Een cirkeldiagram kan bij een kwalitatieve variabele: elk geslacht krijgt een eigen sector.
Opdracht 2
a Ordinaal, want de klassen zijn geen hoeveelheden meer, maar ze hebben wel een logische volgorde (van kort naar lang).
b Bij een kwalitatieve variabele kun je een staafdiagram en een cirkeldiagram maken.
c Voor een schatting van het gemiddelde gebruik je de klassenmiddens. De klassen ⟨←; 1,70] en ⟨1,90; →⟩ zijn open: ze hebben geen ondergrens of geen bovengrens, en dus geen klassenmidden.
Opdracht 3
a Ordinaal, want de waarden (nooit, soms, regelmatig, vaak) zijn geen hoeveelheden en hebben een logische volgorde.
b Tel de percentages op tot en met "vaak". Dat is alles behalve "altijd":
- taalvakken: 100% − 6,8% = 93,2%;
- exacte vakken: 100% − 10,7% = 89,3%.
c Bij een ordinale variabele met dit diagram kun je van de centrummaten alleen de modus gebruiken. Een spreidingsmaat kun je niet gebruiken, want die heeft hoeveelheden nodig.
d Een cirkeldiagram of een gewoon (niet gestapeld) staafdiagram met percentages. Die geven, net als het gestapelde staafdiagram, een goede indruk van de verdeling over de categorieën.
Opdracht 4
a De variabele geslacht (jongens en meisjes). Het meetniveau is nominaal.
b Groep 1 zijn de jongens.
- Bij de jongens komen grote aantallen (boven 20) relatief vaker voor dan bij de meisjes, en kleine aantallen (onder 20) relatief minder vaak. Het gemiddelde is dus bij de jongens groter, en 22,7 > 13,4.
- Bij de meisjes liggen de waarnemingen verder uit elkaar, dus hun standaardafwijking is groter, en 23,9 > 19,2.
c Van de centrummaten de mediaan. De modus bestaat bij de jongens niet. Van de spreidingsmaten de spreidingsbreedte en de interkwartielafstand.
d Nee. Voor een puntenwolk moet je per leerling beide waarden weten: het aantal liedjes én de leeftijd. Uit twee losse diagrammen kun je niet halen welke waarden bij dezelfde leerling horen.
Opdracht 5
a De gemiddelde dagtemperatuur is kwantitatief, want de waarden zijn hoeveelheden. De variabele maand is ordinaal, want de maanden zijn geen hoeveelheden en hebben een logische volgorde.
b De rode boxplots horen bij periode II. De blauwe liggen doorgaans lager, en het is in periode II warmer.
c Lees af: Q₁ = 3 en Q₃ = 7. De interkwartielafstand is 7 − 3 = 4.
Er is een uitschieter bij een dagtemperatuur onder −3 °C of boven 13 °C.
d Bijvoorbeeld januari in periode I. Die boxplot hoort bij een links-scheve verdeling: de linker staart is lang. Een paar heel koude dagen trekken het gemiddelde dan omlaag, onder de mediaan.
e Neem van alle boxplots van één periode de laagste en de hoogste waarde, zonder de uitschieters.
- Periode I: laagste Q₀ = −9 en hoogste Q₄ = 22, dus spreidingsbreedte 22 − (−9) = 31 °C.
- Periode II: laagste −5 en hoogste 26, dus ook 26 − (−5) = 31 °C.
Opdracht 6
a Lees de eindwaarde van de cumulatieve frequentiepolygonen af: 350 dagen per jaar.
b De rode polygonen horen bij 2024. Daar komen grote aantallen verhuurde kamers minder vaak voor, en de verhuur loopt terug.
c Lees de mediaan af bij de halve totale frequentie (175) op de cumulatieve polygonen.
- 2019: mediaan ongeveer 51 kamers, modale klasse [60, 70⟩.
- 2024: mediaan ongeveer 38 kamers, modale klasse [40, 50⟩.
Zowel de mediaan als de modale klasse is in 2024 lager, dus het gaat slechter.
d Lees af in welke klasse de cumulatieve frequentie 175 bereikt wordt: in 2019 in [50, 60⟩, in 2024 in [30, 40⟩. Een mediaan van 53 kan kloppen (2019), maar een mediaan van 40 niet (die zou in [40, 50⟩ liggen).
e De totalen zijn gelijk. Ligt een punt van de ene relatieve frequentiepolygoon hoger, dan is in die klasse de frequentie groter. Dan stijgt de cumulatieve polygoon daar sneller. De rode relatieve polygoon ligt boven de blauwe tot en met de klasse [40, 50⟩. Dus tot 50 verhuurde kamers per dag gaat de rode cumulatieve polygoon steiler omhoog.
Opdracht 7
a De punten liggen rond een lijn van linksonder (lage prijs, laag salaris) naar rechtsboven (hoge prijs, hoog salaris).
b Twee landen hebben dezelfde Big Mac-prijs én hetzelfde salaris, en vallen dus op hetzelfde punt: Estland en Portugal.
c Het gemiddelde is niet geschikt. Bij een rechts-scheve verdeling trekken de paar hoge salarissen het gemiddelde omhoog. Het gemiddelde is dan geen "doorsnee" salaris meer.
d Kwantitatief, want de waarden zijn hoeveelheden (bedragen in euro).
e Het aantal Big Macs is salaris gedeeld door prijs. Denemarken heeft een hoog salaris en een niet te hoge prijs: ongeveer 2950 / 4,40 ≈ 670 Big Macs.
Controle: alle punten met evenveel Big Macs liggen op een lijn door de oorsprong. Bij 670 Big Macs gaat die lijn ook door (3; 2010), want 3 · 670 = 2010. Boven die lijn ligt geen ander land. Het antwoord is Denemarken.
f Bij precies 250 Big Macs liggen de punten op de lijn door (3; 750) en (5; 1250), want 3 · 250 = 750 en 5 · 250 = 1250. De landen onder die lijn zijn Letland, Hongarije, Litouwen, Tsjechië, Estland, Portugal en Griekenland.
Opdracht 8
a Een dotplot.
b Gebruik de dotplots of reken de kansen uit.
- Minstens 10: kies optie 2 (de D12). Bij de D12 is de kans 3/12 = 25%, bij twee D6 maar 6/36 ≈ 17%.
- Niet minder dan 4: kies optie 1 (twee D6). Bij twee D6 is de kans 1 − 3/36 ≈ 92%, bij de D12 maar 9/12 = 75%.
c Bij optie 1 hoort (bij benadering) een normale verdeling: klokvormig, met veel uitkomsten in het midden. Bij optie 2 hoort een uniforme verdeling: elke uitkomst komt ongeveer even vaak voor.
d Bij optie 1 (de D6-worpen). Daar liggen veel uitkomsten rond het gemiddelde en zijn er relatief weinig lage en hoge uitkomsten. De spreiding is dus kleiner.
Opdracht 9
Ga uit van 100 sporters: 70 vrouwen en 30 mannen. Lees in de diagrammen af dat 50% van de vrouwen en 60% van de mannen een medaille won.
Daarvan zijn 35 vrouw:
Opdracht C1
a Lees in het spreidingsdiagram af bij 200 cm: 90 kg.
b Het gewicht is afgerond op 5 kg en de lengte op 5 cm. Alle waarden liggen op veelvouden van 5.
c Door af te ronden gaat informatie verloren: je weet de precieze waarden niet meer.
d In elke dotplot staan 17 stippen, dus van 17 sporters.
e Vergelijk per gewicht het aantal stippen. Bij 50, 55 en 70 kg staan in het spreidingsdiagram minder stippen dan in de dotplot. Daar vallen dus meerdere sporters op één stip: 50, 55 en 70 kg.
f In het spreidingsdiagram zie je de samenhang tussen gewicht en lengte. In de dotplots zie je de verdeling van de gewichten en van de lengtes, en ook stippen die samenvallen.
Opdracht C2
a De boxplot. Daarin zie je de spreidingsbreedte en de interkwartielafstand.
b De BMI heeft veel verschillende waarden. Een cirkeldiagram met kwantitatieve data zou heel veel kleine sectoren krijgen en onoverzichtelijk zijn. Daarom zijn er eerst categorieën van gemaakt.
10.1 Statistische diagrammen nagekeken?
17 opdrachten
Zo pak je het aan
Samenhang beschrijven. In een puntenwolk zie je een samenhang als de punten rond een stijgende of dalende lijn liggen. Beschrijf hem in de vorm "bij grotere ... horen over het algemeen grotere (of kleinere) ...".
Causaliteit. Een samenhang is alleen causaal (oorzakelijk) als aan beide voorwaarden is voldaan.
- De oorzaak gaat vooraf aan het gevolg.
- Er zijn geen andere variabelen die de samenhang verklaren.
Eén verklarende variabele is genoeg om te zeggen dat er geen causaal verband is. Om alle andere variabelen in één keer uit te sluiten, deel je de proefpersonen aselect (door toeval) in groepen in. Dan zijn alle andere variabelen ongeveer gelijk verdeeld over de groepen.
Groepen vergelijken met het examenformuleblad. Kies de methode bij de gegevens die je hebt, en noem die keuze in je antwoord:
| welke gegevens heb je? | methode |
|---|---|
| frequenties bij een variabele met twee categorieën (2×2-kruistabel) | phi-coëfficiënt |
| (cumulatieve) frequenties of percentages bij een klassenindeling of een ordinale variabele met meer dan twee categorieën | max Vcp |
| steekproefgemiddelden en steekproefstandaardafwijkingen | effectgrootte E |
| boxplots (of Q₁, mediaan en Q₃) | boxplots vergelijken |
Werk daarna altijd in drie stappen:
- Noem de gegevens en de methode: "..., dus gebruik de ...".
- Bereken de maat. Bij phi gebruik je absolute aantallen, geen percentages. Bij max Vcp gebruik je cumulatieve percentages. Bij E zet je het grootste gemiddelde voorop.
- Vergelijk met de grenzen op het examenformuleblad en trek de conclusie: "Omdat ..., is het verschil groot / middelmatig / gering."
Gebruik max Vcp niet als je maar twee categorieën hebt (gebruik dan phi). Max Vcp mag je gebruiken als beide groepen groter zijn dan 100.
Opdracht 10
a De punten liggen rond een stijgende lijn: bij grotere lengtes horen over het algemeen hogere scores.
b Nee. Je scoort hoger op een kennistoets doordat je meer kennis hebt, niet doordat je langer bent. Een andere variabele, het aantal jaren onderwijs, verklaart de samenhang. Oudere leerlingen zijn langer én weten meer.
Opdracht 11
a De punten liggen rond een dalende lijn: bij een grotere mate van ongezond eten hoort over het algemeen een lagere score.
b Ja. De leerlingen hebben (ongezond) gegeten vóórdat ze de toets maakten. De oorzaak gaat vooraf aan het gevolg.
c In elk van de drie figuren liggen de punten niet rond een stijgende of dalende lijn. Bij meer ongezond eten hoort daar niet duidelijk een hogere of lagere score.
d Van "hoog" naar "laag" schuiven de puntenwolken naar rechts (meer ongezond eten) en omlaag (lagere scores).
e Discipline is een variabele die de samenhang verklaart. Daarmee is niet voldaan aan de tweede voorwaarde. Er is dus geen causaal verband tussen ongezond eten en de score.
f Nee. Er kan nog een andere variabele zijn die de samenhang tussen discipline en score verklaart. Dan is weer niet aan de tweede voorwaarde voldaan.
Opdracht 12
Steeds is er een andere variabele die beide variabelen beïnvloedt:
a De temperatuur: bij warm weer eten mensen meer ijsjes en gaan ze vaker zwemmen.
b De temperatuur: bij kou dragen mensen vaker een muts, en virussen verspreiden zich dan makkelijker.
c Het inkomen van de gezinnen: met een hoger inkomen heb je een groter huis (meer energieverbruik) en een duurdere auto.
d De omvang van de brand: bij een grotere brand komen meer brandweerlieden, en is er meer schade.
Opdracht 13
a Nee. De omvang van de bovenarmen van de jongens is niet vergeleken met die van vóór het gewichtheffen, maar met die van de meisjes. Er is dus niet vastgesteld dat de oorzaak voorafgaat aan het gevolg. Bovendien is geslacht een andere variabele die het verschil kan verklaren.
b Nog steeds niet. De leerlingen kozen zelf of ze meededen, dus de groepen zijn niet aselect ingedeeld. Er kan een andere variabele zijn die het verschil verklaart, bijvoorbeeld dat leerlingen die graag gewichtheffen al meer aanleg voor spieropbouw hebben of buiten school meer sporten. Aan de tweede voorwaarde is dus niet voldaan.
Opdracht 14
a Leerlingen met veel inzet leren beter voor toetsen én maken vaker de extra opgaven. Inzet kan dus beide verklaren.
b De leerlingen zijn aselect (door toeval) in de groepen ingedeeld. Dan komt elk niveau van inzet in beide groepen ongeveer even vaak voor.
c Nee. Inzet is in beide groepen ongeveer gelijk verdeeld, dus inzet kan het verschil tussen de groepen niet verklaren.
d Door de aselecte indeling zijn alle andere variabelen die de samenhang zouden kunnen verklaren, ongeveer gelijk verdeeld over de groepen. Het is dus onwaarschijnlijk dat een andere variabele het verschil verklaart.
e Ja. Eerst kregen de leerlingen vier maanden les met afwisselende opgaven, daarna kwam de toets.
f Ja. Aan de eerste voorwaarde is voldaan (vraag e). Door de aselecte indeling zijn alle andere verklarende variabelen uitgesloten, dus ook aan de tweede voorwaarde is voldaan (vraag d). Afwisselende opgaven zijn dus een oorzaak van hogere cijfers.
Opdracht 15
- De effectgrootte kan Jarno niet gebruiken. Daarvoor heb je steekproefgemiddelden en standaardafwijkingen nodig, en "wel of geen hond" is geen kwantitatieve variabele.
- De phi-coëfficiënt kan hij wel gebruiken. Het gaat om een variabele met twee categorieën (wel of geen hond) bij twee groepen, en hij heeft absolute aantallen in een kruistabel.
Opdracht 16
a Tel per school de categorieën bij elkaar op.
| school A | school B | totaal | |
|---|---|---|---|
| negatief | 57 + 28 = 85 | 23 + 41 = 64 | 149 |
| positief | 27 + 16 = 43 | 37 + 21 = 58 | 101 |
| totaal | 128 | 122 | 250 |
b Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
c De conclusie uit het voorbeeld (middelmatig verschil, met max Vcp) is het best te verdedigen. Door vier categorieën samen te voegen tot twee, gaat informatie verloren: het verschil tussen "helemaal niet mee eens" en "niet mee eens" telt dan niet meer mee.
Opdracht 17
a Er staan boxplots in de figuur, dus vergelijk de boxplots. Bij 2013 en 2022 overlappen de boxen elkaar, en een mediaan ligt buiten de box van de andere boxplot. Het verschil is middelmatig.
b Bijvoorbeeld 2013 en 2015: daar overlappen de boxen elkaar niet, dus het verschil is groot.
c Lisa heeft gelijk. Zonder 2013 overlappen alle boxen elkaar, en liggen de medianen steeds binnen de box van de andere boxplot. Dan is het verschil gering.
Opdracht 18
Steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte. Zet het grootste gemiddelde voorop: zonder exoskelet 9,57 en met exoskelet 8,70 watt per kg.
Omdat E > 0,8, is het verschil groot.
Opdracht 19
a Video's over sport verliezen snel hun actualiteit: na een wedstrijd wil men het resultaat meteen zien. Een film blijft langer interessant. De polygoon van sport stijgt daarom in het begin veel sneller.
b Cumulatieve frequenties bij een klassenindeling, dus gebruik max Vcp. Zoek bij elk paar het grootste verticale verschil tussen de polygonen.
- Sport: max Vcp = 75 − 30 = 45. Omdat max Vcp > 40, is het verschil groot.
- Nieuws: max Vcp = 55 − 30 = 25. Omdat 20 < max Vcp ≤ 40, is het verschil middelmatig.
- Film: max Vcp = 30 − 20 = 10. Omdat max Vcp ≤ 20, is het verschil gering.
Opdracht 20
a Bereken eerst de ontbrekende aantallen: 3586 − 596 = 2990 koningsjaren, 889 − 154 = 735 oorlogsjaren onder een koning, 596 − 154 = 442 en 2990 − 735 = 2255.
| oorlogsjaren | vredesjaren | totaal | |
|---|---|---|---|
| koningen | 735 | 2255 | 2990 |
| koninginnen | 154 | 442 | 596 |
| totaal | 889 | 2697 | 3586 |
b 735 / 889 · 100% ≈ 82,7%.
c Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering. Koningen voerden dus niet relatief vaker oorlog dan koninginnen.
Opdracht 21
a 54% van de 108 geweldloze groepen was succesvol: 0,54 · 108 = 58,3..., dus 58 groepen.
b Ordinale variabele met meer dan twee categorieën, dus gebruik max Vcp. Maak de cumulatieve percentages.
| geweldloos cum. % | gewelddadig cum. % | Vcp | |
|---|---|---|---|
| mislukking | 21% | 62% | 41% |
| gedeeltelijk succes | 46% | 75% | 29% |
| succes | 100% | 100% | 0% |
Max Vcp = 41. Omdat max Vcp > 40, is het verschil groot.
c Na het samenvoegen is succes 25% + 54% = 79% bij de geweldloze en 13% + 25% = 38% bij de gewelddadige groepen. Voor phi heb je absolute aantallen nodig. Er zijn 108 geweldloze en 324 − 108 = 216 gewelddadige groepen.
| geweldloos | gewelddadig | totaal | |
|---|---|---|---|
| mislukking | 0,21 · 108 ≈ 23 | 0,62 · 216 ≈ 134 | 157 |
| succes | 0,79 · 108 ≈ 85 | 0,38 · 216 ≈ 82 | 167 |
| totaal | 108 | 216 | 324 |
Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
Omdat −0,4 ≤ phi < −0,2, is het verschil middelmatig.
Opdracht 22
a Lees in de tabel af dat in China het cumulatieve percentage bij 7 gelijk is aan 65%. Dus 65% geeft een 7 of lager, en 100% − 65% = 35% geeft een 8 of hoger. Daniek heeft gelijk.
b Ordinale variabele met meer dan twee categorieën, dus gebruik max Vcp. Bereken per score het verschil in cumulatief percentage. Het grootste verschil is bij score 7: max Vcp = 65 − 55 = 10. Omdat max Vcp ≤ 20, is het verschil gering.
c Lees af: tot en met 5 is 17% (China) en 22% (VS). Bij 1000 inwoners geeft dat 170 en 220 ongelukkigen.
| ongelukkig | gelukkig | totaal | |
|---|---|---|---|
| China | 170 | 830 | 1000 |
| VS | 220 | 780 | 1000 |
| totaal | 390 | 1610 | 2000 |
Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
Opdracht 23
a In de teller van phi staat 20 · 36 − 30 · 24 = 720 − 720 = 0. Dan is phi = 0, en dat betekent: geen verschil.
b Jongens: 20 / 50 · 100% = 40%. Meisjes: 24 / 60 · 100% = 40%. In beide groepen kiest even veel procent wiskunde A, dus dat klopt met Amars conclusie.
c Alle jongens A en alle meisjes B:
Alle jongens B en alle meisjes A:
De phi-coëfficiënt is dus minimaal −1 en maximaal 1.
Opdracht C3
Kijk eerst wat voor samenhang de twee figuren laten zien. In de puntenwolk horen bij hogere waarden van variabele 1 hogere waarden van variabele 2: een positieve samenhang. In de kruistabel komen "laag" bij de ene en "hoog" bij de andere variabele juist het vaakst samen voor: een negatieve samenhang.
a Puntenwolk. Bij meer tijd besteed aan het leren van de woordjes horen over het algemeen meer goede antwoorden: een positieve samenhang.
b Kruistabel. Bij een hogere prijs per loempia horen over het algemeen minder verkochte loempia's: een negatieve samenhang.
c Puntenwolk. Bij een hogere dagtemperatuur horen over het algemeen meer verkochte ijsjes: een positieve samenhang.
Opdracht C4
a Ja: bij meer gamen hoort over het algemeen een lagere reactietijd.
b Teken een puntenwolk met "frequentie gamen" horizontaal en "reactietijd" verticaal. De punten liggen rond een dalende lijn.
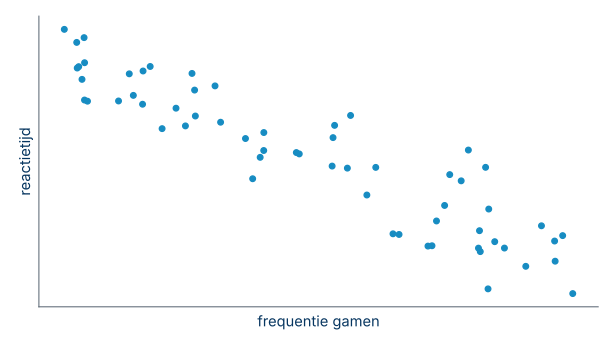
c Nee. Er kan een andere variabele zijn die de samenhang verklaart (bijvoorbeeld leeftijd: jongere mensen gamen vaker en reageren sneller). Dan is niet voldaan aan de tweede voorwaarde voor causaliteit.
Opdracht C5
a Je hebt van beide groepen Q₁, de mediaan en Q₃ (de waarden bij 25%, 50% en 75%), dus gebruik boxplots vergelijken.
b Gamecontroller: box [51, 59] met mediaan 55. Toetsenbord en muis: box [45, 52] met mediaan 47. De boxen overlappen elkaar (van 51 tot 52), en de mediaan 55 ligt buiten de andere box. Het verschil is middelmatig.
10.2 Causaliteit en groepen vergelijken nagekeken?
28 opdrachten
Zo pak je het aan
Steekproeven. Een steekproef is aselect als elk element uit de populatie een even grote kans heeft om in de steekproef te komen. Alleen bij een aselecte en voldoende grote steekproef mag je iets zeggen over de populatie.
Vuistregels bij de normale verdeling (gemiddelde μ, standaardafwijking σ):
- ongeveer 68% ligt tussen μ − σ en μ + σ;
- ongeveer 95% ligt tussen μ − 2σ en μ + 2σ;
- bijna 100% ligt tussen μ − 3σ en μ + 3σ.
De verdeling is symmetrisch. Daarom ligt 16% boven μ + σ en 2,5% boven μ + 2σ. Teken altijd een schets met deze percentages.
95%-betrouwbaarheidsintervallen (examenformuleblad):
Werk in twee stappen. Bereken eerst σ = S/√n (of σ = √(p̂(1 − p̂)/n)). Daarna geeft het interval [X̄ − 2σ, X̄ + 2σ]. Rond een interval voor een proportie af op drie decimalen, tenzij er iets anders gevraagd wordt.
De steekproefomvang berekenen. De breedte van het interval is 4σ. Los de vergelijking op met de optie oplossen. Is p̂ nog niet bekend, gebruik dan p̂ = 0,5: dat geeft de grootste breedte.
Een onderzoeksopzet beoordelen. Is de steekproef aselect? Is hij groot genoeg? Is er een controlegroep? Zijn de groepen aselect ingedeeld? Gaat de conclusie niet verder dan de onderzochte groep?
Opdracht V4
Volgens de vuistregels ligt 2,5% onder μ − 2σ = 400 − 2 · 15 = 370 gram.
Je verwacht dus ongeveer 99 producten lichter dan 370 gram. Dat komt goed overeen met de 97 die er werkelijk zijn.
Opdracht V5
a
b Nee. De steekproef is alleen op de kinderafdeling genomen. Niet alle patiënten in het ziekenhuis hebben dus een even grote kans om in de steekproef te komen.
c De populatieproportie is 50 / aantal patiënten = 0,05, dus het aantal patiënten is:
Opdracht V6
a De 95% ligt symmetrisch rond het gemiddelde, van μ − 2σ tot μ + 2σ.
b 66 = μ + 2σ. Boven μ + 2σ ligt 2,5%.
c De steekproefproportie is p̂ = 0,012. 5 zandlopers zijn 1,2% van de steekproef:
Opdracht V7
a
Het interval is [114; 126].
b Hier is S/√n = 0,32 al gegeven, dus σ = 0,32:
Het interval is [17,36; 18,64].
c
Het interval is [0,429; 0,531].
d p̂ = 5/9 = 0,5555...
Het interval is [0,546; 0,565], oftewel [54,6%; 56,5%] als populatiepercentage.
Opdracht V8
a Los op:
De optie oplossen geeft x = 2100. De steekproefomvang moet minstens 2100 zijn.
b Los op:
De optie oplossen geeft x = 400. De steekproefomvang moet minstens 400 zijn.
Opdracht V9
a
Het interval is [143,5; 156,5] minuten.
b
Het interval is [0,52; 0,68].
Opdracht 24
a In 95% van de gevallen tussen 17 en 19 mm, dus μ − 2σ = 17 en μ + 2σ = 19.
De maximale standaardafwijking is 0,5 mm. Bij een grotere σ valt meer dan 5% buiten [17, 19].
b Een spreidingsdiagram, want het gaat om de samenhang tussen twee kwantitatieve variabelen. Je moet per olijf de diameter én de tijd tot bederf weten.
Opdracht 25
a De populatie is alle klimaatwetenschappers. De steekproef is de groep van 79 ondervraagde klimaatwetenschappers.
b Volgens Bram is de populatie alle artikelen (uit 1991–2011) waarin een mening werd gegeven. Die zijn allemaal onderzocht, dus 0,971 is dan een populatieproportie.
c De steekproef is niet aselect. Alleen artikelen waarin een mening werd gegeven, hebben kans om in de "steekproef" te komen. De andere twee derde van de 12 000 artikelen niet.
Opdracht 26
a Het percentiel bij 2,02 m is 97,0, dus 100% − 97% = 3% van de mannen is langer dan 2,02 m. Dat zijn 190 mannen.
b Gebruik μ = 1,82 en σ = 0,10 en vergelijk met de vuistregels.
- Tussen μ − σ = 1,72 en μ + σ = 1,92 hoort 68% te liggen. In de tabel: 83,2% − 14,7% = 68,5%. Dat is weinig verschil.
- Tussen μ − 2σ = 1,62 en μ + 2σ = 2,02 hoort 95% te liggen. In de tabel: 97,0% − 2,0% = 95,0%. Dat is geen verschil.
- Tussen μ − 3σ = 1,52 en μ + 3σ = 2,12 hoort bijna 100% te liggen. In de tabel: 99,9% − 0,1% = 99,8%. Dat is weinig verschil.
Opdracht 27
a
Het interval is [0,132; 0,318]. Op elke autobezitter zijn er twee mensen zonder auto, dus 1 op de 3 heeft een auto. De populatieproportie is 1/3 = 0,333..., en die ligt niet in het interval.
b Ik ben het niet met Lieke eens. Ook bij aselecte steekproeven valt de populatieproportie bij ongeveer 5% van de steekproeven buiten het 95%-betrouwbaarheidsinterval. Dit kan zo'n steekproef zijn.
Opdracht 28
a De populatie is alle piercing- en tatoeageshops in Nederland (in 2012). De steekproef is aselect (aselect gekozen uit een lijst van alle shops).
Het interval is [0,218; 0,387].
b De populatie is alle Nederlandse jongeren. De steekproef is niet aselect: alleen jongeren die zich zelf bij het panel hebben aangemeld, hebben kans om in de steekproef te komen.
c De populatie is alle berichten over de zanger op dat platform. Er is geen steekproef: alle 5000 berichten zijn onderzocht, dus de hele populatie.
Opdracht 29
a Hoger. Je verwacht dat vooral sterke mensen mee willen doen, en die houden het gewicht langer omhoog.
b Hoger. Er zijn alleen bedrijven onderzocht die al verdacht werden van fraude, en bij die bedrijven verwacht je vaker fraude dan bij alle boerenbedrijven samen.
Opdracht 30
a Los op:
De optie oplossen geeft x = 5100. Hij moet minstens 5100 mensen in zijn steekproef opnemen.
b Gelijk. De populatieomvang komt niet voor in de formule voor het betrouwbaarheidsinterval. Met dezelfde p̂ en dezelfde breedte heb je dus dezelfde steekproefomvang nodig, of de populatie nu 18 miljoen of 8,2 miljard mensen telt.
c Er bestaat geen lijst van de hele wereldbevolking waaruit je aselect kunt trekken: lang niet iedereen staat ergens geregistreerd. Bovendien zijn veel mensen moeilijk te bereiken.
Opdracht 31
a Hoe groter de steekproefomvang, hoe kleiner σ en hoe smaller (nauwkeuriger) het betrouwbaarheidsinterval. Het interval voor het VO (honderden docenten) is dus veel smaller dan dat voor het HO (37 docenten).
b Lees in het diagram af dat 29% van de HO-docenten het eens is: p̂ = 0,29.
Het interval is [14,1%; 43,9%].
c De breedte is 0,712 − 0,628 = 0,084, en het midden is p̂ = 0,67. Los op:
De optie oplossen geeft x = 501,3... De steekproefomvang was ongeveer 500 docenten.
Opdracht 32
a Het maximum voor een heel jaar is 366 · 55 = 20 130 gram. Met 89 gram per dag is dat op na:
Op dag 227 is het maximum voor het hele jaar bereikt, en dag 227 is 14 augustus 2024.
b De suikermaxdag is berekend met het steekproefgemiddelde van 89 gram. Het populatiegemiddelde kan daarvan afwijken. Bij een ander gemiddelde hoort een andere suikermaxdag.
c Bereken eerst het 95%-betrouwbaarheidsinterval voor het gemiddelde suikergebruik per dag.
Bij meer suiker per dag is het maximum eerder bereikt:
Dag 219 is 6 augustus en dag 235 is 22 augustus. Het interval is [6-8-2024; 22-8-2024].
Opdracht 33
a Nee. Bij de lengte kun je de modus bepalen, maar bij het gewicht niet: de gewichten 56 kg en 70 kg komen allebei drie keer voor, dus er is geen modus.
b Nee. Bij 25 jongens is de mediaan het 13e waarnemingsgetal (op volgorde). De mediane lengte is 176 cm, en daarbij hoort een gewicht van 66 kg of 72 kg. Het mediane gewicht is 63 kg. De jongen met de mediane lengte heeft dus niet het mediane gewicht.
c Elke groep bestaat uit 5 jongens (20% van 25). De spreidingsbreedtes van de lengte zijn achtereenvolgens 166 − 160 = 6 cm, 172 − 168 = 4 cm, 178 − 173 = 5 cm, 183 − 179 = 4 cm en 194 − 185 = 9 cm. De spreidingsbreedte is het grootst bij de 20% langste jongens.
d 12% van 25 is 3 jongens.
- De drie langste: 187 cm (70 kg), 192 cm (75 kg) en 194 cm (70 kg).
- De drie zwaarste: 72 kg (176 cm), 74 kg (185 cm) en 75 kg (192 cm).
Alleen de jongen van 192 cm en 75 kg hoort bij beide groepen. Dat is 1 / 25 · 100% = 4%.
e De klasse [167, 185] is [176 − 9, 176 + 9], dus [μ − σ, μ + σ]. Ze controleert de vuistregel dat ongeveer 68% tussen μ − σ en μ + σ ligt.
In het diagram hebben 17 jongens een lengte in die klasse: 17 / 25 · 100% = 68%. Dat komt overeen met de vuistregel.
Opdracht 34
a Bij de referentiewaarden ligt 95% tussen μ − 2σ en μ + 2σ. Het midden is dus μ, en de breedte is 4σ.
- Mannen: μ = (0,90 + 2,10) / 2 = 1,5 mmol/L en σ = (2,10 − 0,90) / 4 = 0,3 mmol/L.
- Vrouwen: μ = (1,10 + 2,20) / 2 = 1,65 mmol/L en σ = (2,20 − 1,10) / 4 = 0,275 mmol/L.
Het gemiddelde is groter bij vrouwen. De standaardafwijking is groter bij mannen.
b Hemoglobine bij vrouwen: μ = (7,5 + 10) / 2 = 8,75 en σ = (10 − 7,5) / 4 = 0,625. Dan is μ + σ = 9,375 mmol/L, en boven μ + σ ligt 16%. 9,5 ligt hoger dan 9,375, dus minder dan 16% van de gezonde vrouwen heeft een gehalte boven 9,5 mmol/L.
c Frequenties bij een klassenindeling, dus gebruik max Vcp. Beide groepen zijn groter dan 100 (512 en 402). Maak de cumulatieve frequenties en percentages.
| klasse | A cum. freq. | A cum. % | B cum. freq. | B cum. % | Vcp |
|---|---|---|---|---|---|
| ⟨←; 2,00] | 132 | 25,8% | 64 | 15,9% | 9,9% |
| ⟨2,00; 2,50] | 316 | 61,7% | 160 | 39,8% | 21,9% |
| ⟨2,50; 3,00] | 441 | 86,1% | 281 | 69,9% | 16,2% |
| ⟨3,00; 4,00] | 498 | 97,3% | 378 | 94,0% | 3,3% |
| ⟨4,00; →⟩ | 512 | 100% | 402 | 100% | 0% |
Max Vcp = 21,9. Omdat 20 < max Vcp ≤ 40, is het verschil middelmatig.
d Nu zijn er twee categorieën: wel of geen verhoogd risico (meer dan 2,50 mmol/L). Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt. Uit de cumulatieve frequenties volgt: in groep A hebben er 316 geen verhoogd risico en 512 − 316 = 196 wel. In groep B zijn dat er 160 en 402 − 160 = 242.
| verhoogd risico | groep A | groep B | totaal |
|---|---|---|---|
| geen | 316 | 160 | 476 |
| wel | 196 | 242 | 438 |
| totaal | 512 | 402 | 914 |
Omdat 0,2 < phi ≤ 0,4, is het verschil middelmatig.
Opdracht 35
a Ze maken de spreiding kleiner. Dan liggen de tonen dichter bij elkaar, en als de hardste toon op 0 dBFS wordt gezet, liggen er meer tonen in de buurt van 0 dBFS.
b Een normale verdeling is symmetrisch. De krommen in de figuur zijn niet symmetrisch, dus de hardheid is in geen enkel jaar normaal verdeeld.
c Een onderschatting. De verdelingen zijn links-scheef: de lange staart ligt aan de zachte (negatieve) kant. Dan is het gemiddelde lager dan de mediaan en de modus. Het gemiddelde is dus lager (zachter) dan de meest voorkomende hardheid.
d Los op: −14 + 0,067t = 0. Dat geeft t = 208,9..., dus t ≈ 209. Het jaar is 1950 + 209 = 2159.
Een gemiddelde van 0 dBFS kan alleen als alle tonen 0 dBFS zijn, want harder dan 0 kan niet. Alle tonen klinken dan even hard.
e Bij Death Magnetic liggen de tonen dicht bij elkaar, dus de hardste toon ligt maar weinig boven de gemiddelde hardheid. Als het volume op de gemiddelde hardheid wordt afgestemd, komt die hardste toon niet ver boven het gemiddelde uit. Bij liedjes met een grote spreiding ligt de hardste toon veel verder boven het gemiddelde. Die klinkt dan dus harder.
Opdracht 36
a Bijvoorbeeld wel of niet geverfd en wel of geen reactie van de koe op de vliegen.
b Steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte.
Omdat E > 0,8, is het verschil groot.
c Het aantal vliegen op een koe is twee keer het aantal op een foto. Elke vlieg steekt elke 4 minuten, dus 60 / 4 = 15 keer per uur.
- Zwarte koeien: 15 · 2 · 128,8 = 3864 steken per uur.
- Gestreepte koeien: 15 · 2 · 55,5 = 1665 steken per uur.
Ongeverfd komt hij boven de 2000, geverfd eronder. Raad hem dus aan zijn koeien te verven.
d Om uit te sluiten dat de vliegen wegblijven door de verf zelf (bijvoorbeeld de geur), en niet door het streeppatroon.
e Bijvoorbeeld:
- er zijn alleen zwarte wagyu koeien onderzocht, en het is mogelijk anders bij andere soorten;
- het onderzoek vond plaats in Japan, waar misschien andere vliegen voorkomen dan elders;
- het ging om maar 6 koeien per groep.
Opdracht 37
a
In de figuur lees je af: 0,472 − 0,428 = 0,044. Dat komt ongeveer overeen.
b Hoe groter de steekproef, hoe smaller het interval. De grootste peiling (105 612) heeft het smalste interval: YouGov. De kleinste peiling (166) heeft het breedste interval: BMG.
c Lees af: het interval van Kantar is [0,42; 0,46]. De breedte is 0,04 en p̂ = 0,44. Los op:
De optie oplossen geeft x = 2464. De steekproefomvang was ongeveer 2464 mensen.
d Het interval van BMG is heel breed, omdat de steekproef klein is. Dan valt de uitslag er makkelijk binnen, maar zegt de peiling weinig over wat de uitslag precies wordt.
e Bij 9 van de 12 peilingen, dus bij 75%. Dat is minder dan de 95% die je zou verwachten. Mogelijke verklaringen: het zijn maar 12 peilingen, zodat toeval een grote rol speelt, of de steekproeven waren niet aselect.
Opdracht 38
a Misschien komen vissen af op de luidsprekers zelf (als schuilplek of uit nieuwsgierigheid) en niet op het geluid. Met stille luidsprekers sluit je dat uit.
b Lees bij "dummy" af: Q₁ = 5 en Q₃ = 13. De interkwartielafstand is 13 − 5 = 8.
De waarneming 34 ligt boven 25, dus meer dan anderhalf keer de interkwartielafstand boven Q₃.
c Ze heeft geen gelijk. In groep 3 is Q₁ = 5 en Q₃ = 18. Boven Q₃ ligt 25% van de metingen en onder Q₁ ook 25%. Er zijn dus niet meer metingen boven 18 dan onder 5.
d Manier 1: er zijn boxplots, dus gebruik boxplots vergelijken.
- Groep 1 en 2: de boxen overlappen (net), en de medianen liggen buiten de box van de andere boxplot. Het verschil is middelmatig.
- Groep 1 en 3: de boxen overlappen, en de medianen liggen buiten de box van de andere boxplot. Het verschil is middelmatig.
Manier 2: steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte.
Omdat E > 0,8, is het verschil steeds groot.
e Ja.
- Aan voorwaarde 1 is voldaan: eerst werden de luidsprekers geplaatst, daarna werden de vissen geteld.
- Aan voorwaarde 2 is voldaan: de koraalriffen zijn aselect in groepen ingedeeld, dus andere variabelen zijn ongeveer gelijk verdeeld over de groepen. De luidsprekers zelf zijn ook geen verklaring, want bij de dummy-groep waren er niet meer vissen.
Geluid van gezonde koraalriffen is dus een oorzaak van meer monniksvissen.
Opdracht 39
a De student met de hoogste score heeft ook de langste gemiddelde slaapduur. De student met de laagste score sliep niet gemiddeld het kortst. Beide zie je in de bovenste figuur.
b
- Uitspraak I volgt uit de bovenste figuur. Er zijn 6 studenten met een gemiddelde slaapduur van minstens 8 uur, en die haalden allemaal minstens 70 punten.
- Uitspraak II volgt uit de onderste figuur. Wie vaker ongeveer even lang slaapt, heeft een kleinere standaardafwijking van de slaapduur, en daarbij horen over het algemeen hogere scores.
c Steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte. Het verschil van de gemiddelden is 6,57.
Omdat 0,4 < E ≤ 0,8, is het verschil middelmatig.
d Nee. De studenten zijn niet aselect ingedeeld: ze kozen zelf hoe lang ze sliepen. Er kan dus een andere variabele zijn die de samenhang verklaart, bijvoorbeeld een regelmatige dagindeling. Dan is niet voldaan aan de tweede voorwaarde.
Opdracht 40
a Lees af bij punt A: bij de hoge inkomens was 28% voorstander, bij de lage inkomens 69%.
b Linksboven staan voorstellen waar de lage inkomens in meerderheid voor zijn (meer dan 50%), maar de hoge inkomens in meerderheid niet.
c In het vlak linksboven zijn 3 van de 38 punten groen:
d Rechtsonder: 10 / 30 · 100% ≈ 33,3% gerealiseerd. Linksboven: 7,9%. Voorstellen die alleen de hoge inkomens steunen, worden verhoudingsgewijs veel vaker gerealiseerd dan voorstellen die alleen de lage inkomens steunen. Praktisch betekent dit dat er bij tegengestelde meningen meer naar de hoge inkomens geluisterd wordt.
e Frequenties bij een variabele met twee categorieën (wel of niet gerealiseerd), dus gebruik de phi-coëfficiënt.
| gerealiseerd | niet gerealiseerd | totaal | |
|---|---|---|---|
| linksboven | 3 | 35 | 38 |
| rechtsonder | 10 | 20 | 30 |
| totaal | 13 | 55 | 68 |
Omdat −0,4 ≤ phi < −0,2, is het verschil middelmatig.
f De voorstellen rechtsboven worden door beide groepen gesteund. Je kunt daaruit net zo goed concluderen dat er naar de hoge inkomens geluisterd wordt. Om te zien naar wie geluisterd wordt, moet je kijken naar voorstellen waarover de groepen het oneens zijn, zoals in vraag d en e. Daar blijkt wel een verschil.
Opdracht 41
a Bij een normale verdeling ligt 2,5% tussen μ − 3σ en μ − 2σ.
Een oppervlakte kan niet negatief zijn, dus tussen −0,017 en −0,005 ligt 0% van de waarnemingen in plaats van 2,5%. De oppervlakte kan dus niet normaal verdeeld zijn.
b
Het interval is [0,0182; 0,0198] km².
c De breedte is 3,478 − 1,273 = 2,205. Los op:
De optie oplossen geeft x = 3,897... Dus S ≈ 3,898.
d Los op:
De optie oplossen geeft x = 243,36. Het onderzoek moet minstens 244 dagen duren.
Opdracht 42
a
- Conclusie I is fout. Tel bij "vogels" alle staven op: 310 + 130 + 30 + 20 + 10 = 500 katten hebben een vogel mee naar huis genomen. Dus 986 − 500 = 486 katten niet.
- Conclusie II is fout. Neem bij de vogels steeds de bovengrens van de klasse, dan krijg je het maximale aantal vogels. Neem bij de zoogdieren steeds de ondergrens, dan krijg je het minimale aantal zoogdieren.
Zelfs dan zijn er meer zoogdieren dan vogels mee naar huis genomen.
b p̂ = 500 / 986 = 0,5070...
Het interval is [0,475; 0,539].
c Bereken eerst het interval voor het gemiddelde aantal mee naar huis genomen prooien per kat in 5 maanden.
Reken daarna om. Er worden 4 keer zoveel prooien gevangen als mee naar huis genomen (25%), een jaar is 12/5 keer 5 maanden, en er zijn 9 miljoen katten.
Het interval is [1182; 1337] miljoen prooien per jaar (1259 ± 78 miljoen).
Opdracht 43
De breedte van het interval voor het gemiddelde per kat is 4 · 134/√n. Voor 2,6 miljoen katten samen is het totaal 2,6 · 10⁶ keer zo groot, en dus ook de breedte. Los op:
De optie oplossen geeft x = 776,8... Er moeten minstens 777 kattenbezitters in de steekproef zitten.
Het gemiddelde van 140 prooien heb je hier niet nodig: de breedte hangt alleen af van S en n.
Opdracht C6
a Opleiding is ordinaal, want de waarden zijn geen hoeveelheden en hebben een logische volgorde. Wel of niet gokken is nominaal, want de waarden zijn geen hoeveelheden en hebben geen logische volgorde.
b Tel alle aantallen op: 6879 jongeren in de steekproef, van wie 112 + 133 + 133 + 76 = 454 gokken.
Het interval is [6,0%; 7,2%] (6,6% ± 0,6%).
c Frequenties bij een ordinale variabele met meer dan twee categorieën, dus gebruik max Vcp.
| opleiding | wel cum. freq. | wel cum. % | niet cum. freq. | niet cum. % | Vcp |
|---|---|---|---|---|---|
| vmbo-bk | 112 | 24,7% | 1162 | 18,1% | 6,6% |
| vmbo-gt | 245 | 54,0% | 2655 | 41,3% | 12,7% |
| havo | 378 | 83,3% | 4509 | 70,2% | 13,1% |
| vwo | 454 | 100% | 6425 | 100% | 0% |
Max Vcp = 13,1. Omdat max Vcp ≤ 20, is het verschil gering.
d Jongens: 0,114 · 3405 ≈ 388 gokken, en 3405 − 388 = 3017 niet. Meisjes: 66 wel en 3474 − 66 = 3408 niet. Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
| gokt wel | gokt niet | totaal | |
|---|---|---|---|
| jongens | 388 | 3017 | 3405 |
| meisjes | 66 | 3408 | 3474 |
| totaal | 454 | 6425 | 6879 |
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
Opdracht C7
Bijvoorbeeld:
- De steekproef is niet aselect: geneeskundestudenten die geen les hebben van deze docent, hebben geen kans om in de steekproef te komen.
- De studenten zijn afhankelijk van de docent. Ze voelen zich misschien niet vrij om zich negatief uit te laten over de verplichting.
10.3 Statistiek toepassen nagekeken?
4 opdrachten
Zo pak je het aan
In deze test komt alles uit 10.1 t/m 10.3 terug. Lukt een opgave niet, kijk dan eerst weer naar "Zo pak je het aan" van die paragraaf. Bij het vergelijken van groepen begin je altijd met de zin "..., dus gebruik de ...".
Test 1
- Vraag I: een lijndiagram, want daarin zie je het verloop in de tijd goed.
- Vraag II: een spreidingsdiagram, want daarin zie je de samenhang tussen twee variabelen goed.
- Vraag III: een dotplot, want daarin zie je de verdeling goed.
Test 2
a Kwalitatief, want de waarden (man, vrouw) zijn geen hoeveelheden.
b Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt. Gevangenschap: 24 mannetjes en 40 − 24 = 16 vrouwtjes. Wild: 27 mannetjes en 41 − 27 = 14 vrouwtjes.
| gevangen | wild | totaal | |
|---|---|---|---|
| man | 24 | 27 | 51 |
| vrouw | 16 | 14 | 30 |
| totaal | 40 | 41 | 81 |
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
c Manier 1: er zijn boxplots, dus gebruik boxplots vergelijken. De boxen overlappen elkaar, en geen van beide medianen ligt buiten de box van de andere boxplot. Het verschil is gering.
Manier 2: steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte.
Omdat 0,4 < E ≤ 0,8, is het verschil middelmatig.
De twee methoden geven hier een verschillende conclusie. E ligt net boven de grens van 0,4.
d Nee. Er kan een andere variabele zijn die de samenhang verklaart (bijvoorbeeld voedsel of temperatuur tijdens het opgroeien). De vlinders zijn niet aselect ingedeeld.
Test 3
a De punten onder de lijn v = f horen bij spelers met v kleiner dan f: dat zijn de punten (56, 51) en (69, 67). Jalen Duren is de betere vrijeworpschutter, dus zijn punt heeft de grootste v: (69, 67).
b Er zijn 25 spelers, dus de mediaan is het 13e getal. Tel de stippen van boven naar beneden: bij de 13e stip hoort v = 75. De mediaan is 75%.
c Rechts-scheef: de meeste stippen staan links in de figuur (lage f), en naar rechts staan er steeds minder.
d Lees af: NJ heeft v = 80 en GA heeft v = 62.
- NJ: 0,80 · 450 = 360 raak en 90 gemist.
- GA: 0,62 · 700 = 434 raak en 266 gemist.
Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
| raak | gemist | totaal | |
|---|---|---|---|
| NJ | 360 | 90 | 450 |
| GA | 434 | 266 | 700 |
| totaal | 794 | 356 | 1150 |
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
Test 4
a p̂ = 0,58 en n = 38.
Het interval is [42,0%; 74,0%].
b De breedte is 0,781 − 0,699 = 0,082, en p̂ = 0,74. Los op:
De optie oplossen geeft x = 457,8... Er zaten ongeveer 460 hbo-studenten in de steekproef.
c De steekproef is niet aselect: studenten die het tijdschrift niet lezen, hebben geen kans om in de steekproef te komen. Bovendien zitten er maar 38 universitaire studenten in de steekproef, en de conclusie gaat over alle studenten.
Kennis- en vaardighedentest nagekeken?
7 opdrachten
Zo pak je het aan
Bij de gemengde opgaven staat niet bij welke paragraaf ze horen. Bepaal bij elke vraag eerst wat voor gegevens je hebt (variabele, diagram, steekproef). Kies daarna de methode uit 10.1 t/m 10.3.
Gemengd 1
a Verpleegkundigen verdienen 11% minder, dus 89% van het loon buiten de zorg.
b Kwalitatief, want de waarden (nooit, soms, vaak, altijd) zijn geen hoeveelheden. Ordinaal, want de waarden hebben een logische volgorde.
c 270 vrouwen zijn 45% van de vrouwen in de steekproef, dus n = 270 / 0,45 = 600.
Het interval is [40,9%; 49,1%].
d In 2020 zaten er 800 − 600 = 200 mannen in de steekproef. Lees af dat 70% van de mannen in 2020 voltijds werkte: 0,70 · 200 + 270 = 410 voltijders.
Neem voor 2010 bijvoorbeeld 20 mannen en 780 vrouwen. Lees af dat 75% van de mannen en 50% van de vrouwen voltijds werkte: 0,75 · 20 + 0,50 · 780 = 405 voltijders. Dan is het aantal voltijders van 2010 naar 2020 juist toegenomen.
Gemengd 2
a Steekproefgemiddelden en steekproefstandaardafwijkingen, dus gebruik de effectgrootte.
Omdat E > 0,8, is het verschil groot.
b De lijn gaat door (20; 2,2) en (60; 7).
Vul (20; 2,2) in: 0,12 · 20 + b = 2,2, dus b = −0,2.
c Los op: 0,12x − 0,2 = 8,4. De optie oplossen geeft x = 71,6... De sporter haalt naar verwachting ongeveer 72 op de oude test.
d De grens op de oude test is 40. Dan is de nieuwe score 0,12 · 40 − 0,2 = 4,6. Bij scores lager dan 4,6 op de nieuwe test worden de extra trainingen aangeboden.
e Zoek de punten waarbij de twee tests verschillend uitvallen. Eén sporter heeft oud minder dan 40 maar nieuw meer dan 4,6: het punt (39; 4,7). Eén sporter heeft oud meer dan 40 maar nieuw minder dan 4,6: het punt (41; 4,5). Dat geldt dus bij 2 sporters.
Gemengd 3
a Kwantitatief, want de waarden zijn hoeveelheden (aantallen snoepjes).
b Op de lijn y = x is de tweede schatting gelijk aan de eerste. Die leerlingen zijn door de discussie niet van gedachten veranderd.
c De punten rechts van de lijn x = 80 (eerste schatting boven 80) liggen bijna allemaal onder de lijn y = x: hun tweede schatting is lager dan de eerste. Je ziet ook dat ze bijna allemaal onder y = 80 liggen.
Gemengd 4
a Niet eens. Een cumulatieve polygoon die hoger ligt, betekent dat bij een bepaald aantal acties al een groter percentage bereikt is. Minder acties per minuut komen bij Alphastar dus juist vaker voor.
b Cumulatieve percentages bij een klassenindeling, dus gebruik max Vcp. Lees het grootste verticale verschil af: max Vcp = 75 − 60 = 15. Omdat max Vcp ≤ 20, is het verschil gering.
c Tel alle gewonnen wedstrijden op.
- Alphastar: 11 + 4 + 10 + 4 + 4 + 10 + 8 + 5 + 5 = 61.
- Menselijke tegenstanders: 3 + 0 + 2 + 4 + 3 + 5 + 6 + 5 + 3 = 31.
Alphastar won bijna twee keer zo vaak.
d Met hetzelfde ras waren er 14 + 7 + 8 = 29 wedstrijden, en Alphastar won er 11 + 4 + 5 = 20. Frequenties bij een variabele met twee categorieën, dus gebruik de phi-coëfficiënt.
| Alphastar | mens | totaal | |
|---|---|---|---|
| gewonnen | 20 | 9 | 29 |
| verloren | 9 | 20 | 29 |
| totaal | 29 | 29 | 58 |
Omdat 0,2 < phi ≤ 0,4, is het verschil middelmatig.
Gemengd 5
a Kwantitatief, want de positie is een hoeveelheid (een afstand op het lijnstuk). Continu, want alle tussenliggende waarden zijn mogelijk.
b Conclusie 2. Die is te algemeen: er zijn alleen Munduruku onderzocht, niet alle inheemse volken. Ook is "grotere aantallen" onduidelijk, want het ging alleen om aantallen van 1 tot 10.
Een verbetering: "Munduruku vinden de aantallen tussen 5 en 10 dichter bij elkaar liggen dan de aantallen tussen 1 en 4."
c Lees af bij de Munduruku. Bij de laagste 50% stippenaantallen is de spreidingsbreedte van de positie 6,5 − 1,5 = 5. Bij de hoogste 50% is die 8 − 6,3 = 1,7.
d Bereken de ondergrens van het 95%-betrouwbaarheidsinterval voor de gemiddelde positie.
Het interval loopt dus van 5,84 tot hoger dan 6,5. Positie 5 ligt niet in het interval. Met minstens 95% betrouwbaarheid plaatsen de Munduruku het stippenaantal 5 dus niet op positie 5.
Gemengd 6
a Mate van tevredenheid is ordinaal, want de waarden zijn geen hoeveelheden en hebben een logische volgorde. Woonomgeving (stad of platteland) is nominaal, want de waarden zijn geen hoeveelheden en hebben geen logische volgorde.
b De mediaan hoort bij een cumulatief percentage van 50%. Tel op vanaf "zeer tevreden".
- Platteland: 22% + 17% = 39% < 50% en 39% + 30% = 69% > 50%. De mediaan is neutraal.
- Stad: 31% < 50% en 31% + 26% = 57% > 50%. De mediaan is tevreden.
De modus is de hoogste staaf: platteland neutraal, stad zeer tevreden.
c p̂ = 0,31 en n = 200.
Het interval is [0,245; 0,375].
d Ordinale variabele met meer dan twee categorieën, dus gebruik max Vcp.
| platteland cum. % | stad cum. % | Vcp | |
|---|---|---|---|
| zeer tevreden | 22% | 31% | 9% |
| tevreden | 39% | 57% | 18% |
| neutraal | 69% | 81% | 12% |
| ontevreden | 88% | 92% | 4% |
| zeer ontevreden | 100% | 100% | 0% |
Max Vcp = 18. Omdat max Vcp ≤ 20, is het verschil gering.
Gemengd 7
a Frequenties bij een variabele met twee categorieën (mannetje of vrouwtje), dus gebruik de phi-coëfficiënt.
Omdat −0,2 ≤ phi ≤ 0,2, is het verschil gering.
b 176 / 300 · 100% ≈ 59% mannetjes, dus 41% vrouwtjes. De verhouding is 59 : 41.
c Bereken de toename van het percentage mannetjes per °C tussen opeenvolgende metingen.
Steeds ongeveer 6,4 per °C. Een lineair verband met 6,4 per °C is dus te verdedigen.
d 1 : 1 betekent 50% mannetjes. Stel P = 6,4T + b op, met het punt (24,4; 42): 6,4 · 24,4 + b = 42, dus b = −114,16.
Los op: 6,4T − 114,16 = 50. De optie oplossen geeft x = 25,65. Bij ongeveer 25,7 °C.
e Lees op de lijn twee punten af: (23, 30) en (27, 60).
Vul (23, 30) in: 7,5 · 23 + b = 30, dus b = −142,5. Het percentage vrouwtjes is 100 min het percentage mannetjes.
f p̂ = 0,44 en n = 250.
Het interval is [37,7%; 50,3%]. De formule geeft bij T = 24,3: P = 7,5 · 24,3 − 142,5 = 39,75%. Dat valt binnen het interval.
g Bij elke temperatuur ligt de middelste 95% tussen μ − 2σ en μ + 2σ. Met σ = 3% is dat 6 procentpunt onder en boven de lijn. Teken dus twee lijnen evenwijdig aan de modellijn:
Bij T = 20 geeft dat 1,5% en 13,5%, en bij T = 30 76,5% en 88,5%. Het gebied tussen deze lijnen is de middelste 95%.
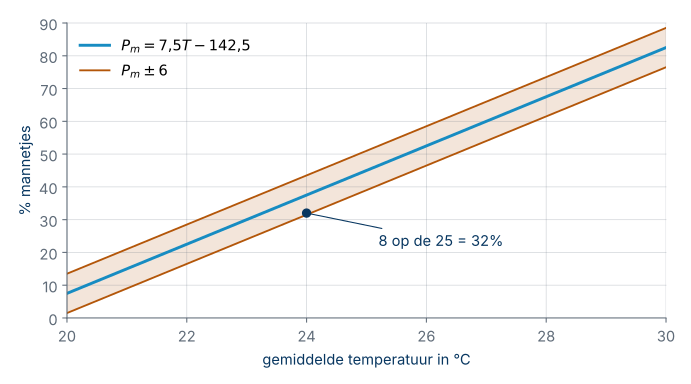
h 8 op de 25 is 32% mannetjes. Bij T = 24 loopt het gebied van 7,5 · 24 − 148,5 = 31,5% tot 7,5 · 24 − 136,5 = 43,5%. Die 32% valt (net) binnen het gebied.
Gemengde opgaven nagekeken?